Tìm hiểu về Flow Matching - Giải thuật Shortcut models
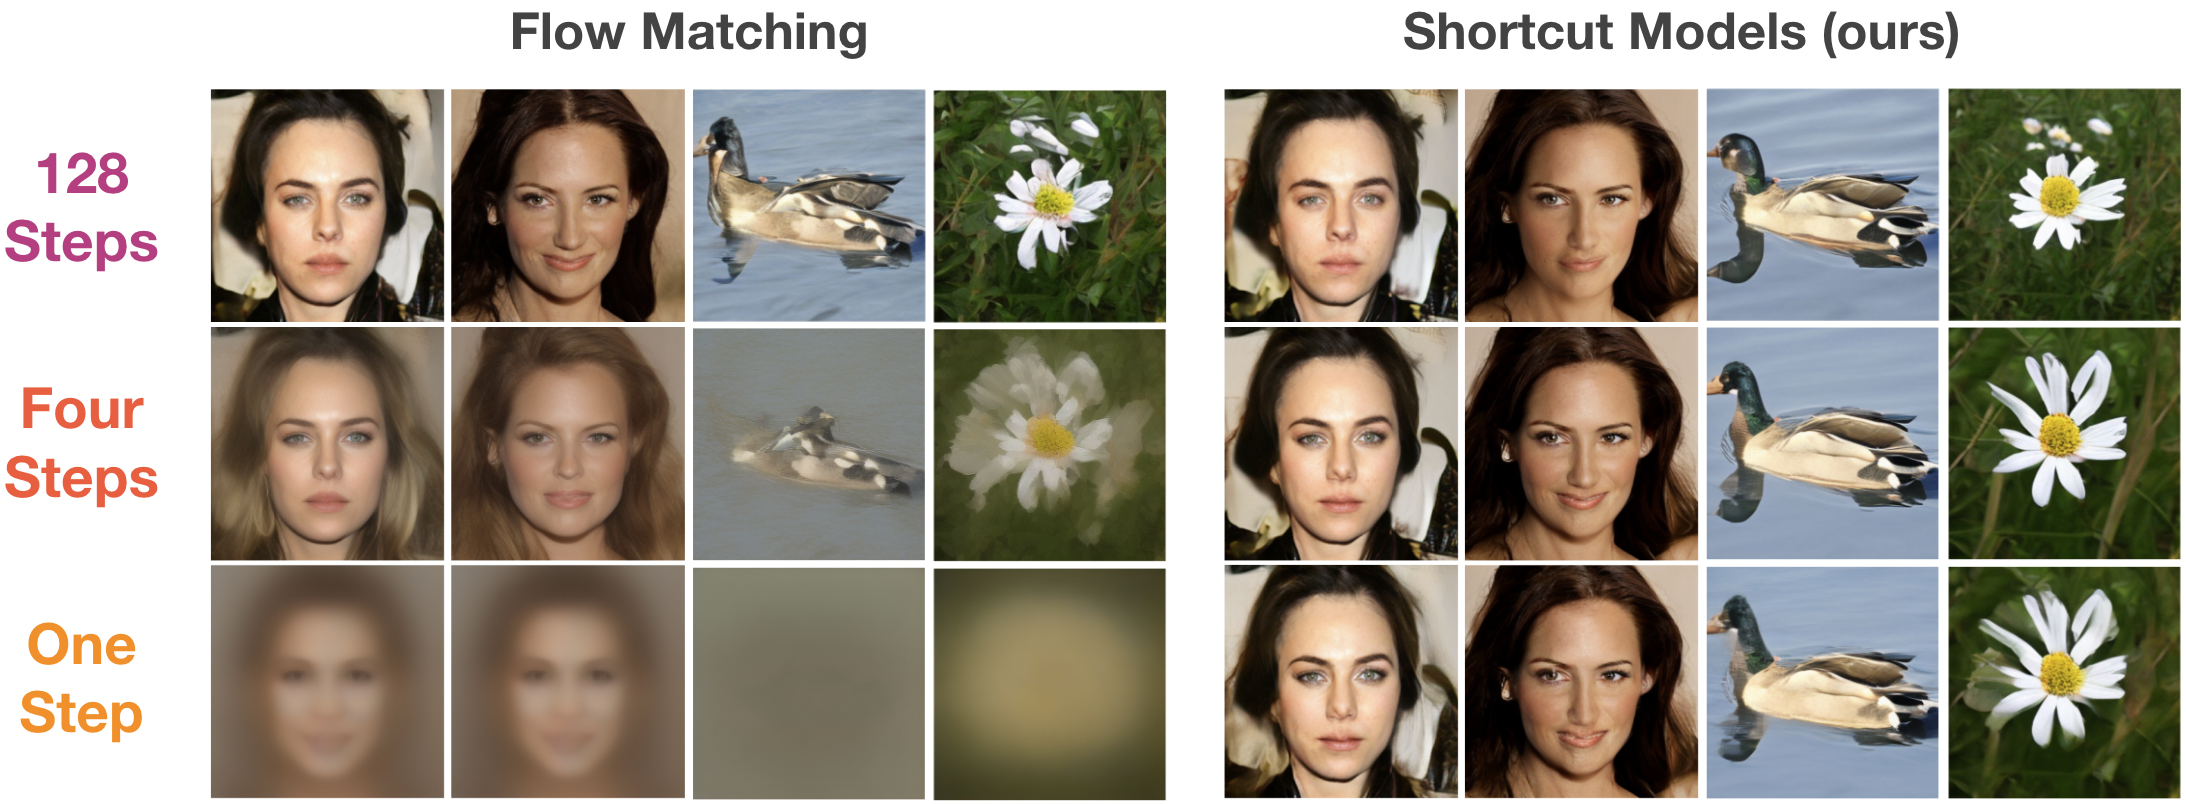
Bài viết này dành cho nhóm bạn đọc: người đã quen với deep learning, Gen AI khi nói về diffusion và lý thuyết học máy thống kê cơ bản.
TL;DR
- Flow Matching viết bài toán sinh dữ liệu thành phép hồi quy MSE, không cần simulation. Đây là backbone mặc định của gen AI — ảnh, video, giọng nói, robotics — nhờ bốn tầng tối ưu, không chỉ vì “nhanh hơn”.
- Giới hạn cứng: ngay cả ở optimum, một bước vẫn có thể thất bại trong phân phối đa modal.
- Shortcut Models1 vượt giới hạn bằng cách điều kiện hóa mạng theo cả $t$ và step size $d$, và huấn luyện end-to-end bằng self-consistency bootstrap. Không teacher, không schedule.
- Paper thực nghiệm thuyết phục nhưng không có phân tích lý thuyết — chính tác giả gọi lời giải thích là “a blind hypothesis”.
- Phân tích trong bài viết chỉ ra: self-consistency là contraction mapping khi $Ld < 1$ — điều kiện paper chỉ áp đặt gián tiếp qua weight decay, và chưa ai đo $L$.
1. Flow Matching: viết lại bài toán sinh dữ liệu thành một phép regression
Continuous Normalizing Flows — mô hình hóa quá trình sinh như vector field $v_\theta(x,t)$ rồi tích phân ODE — không scale được vì phải simulate ODE ngay trong lúc train. Diffusion giải được bài toán scale nhưng đổi lại bộ máy cồng kềnh: SDE thuận/nghịch, noise schedule được thiết kế, score được ước lượng.
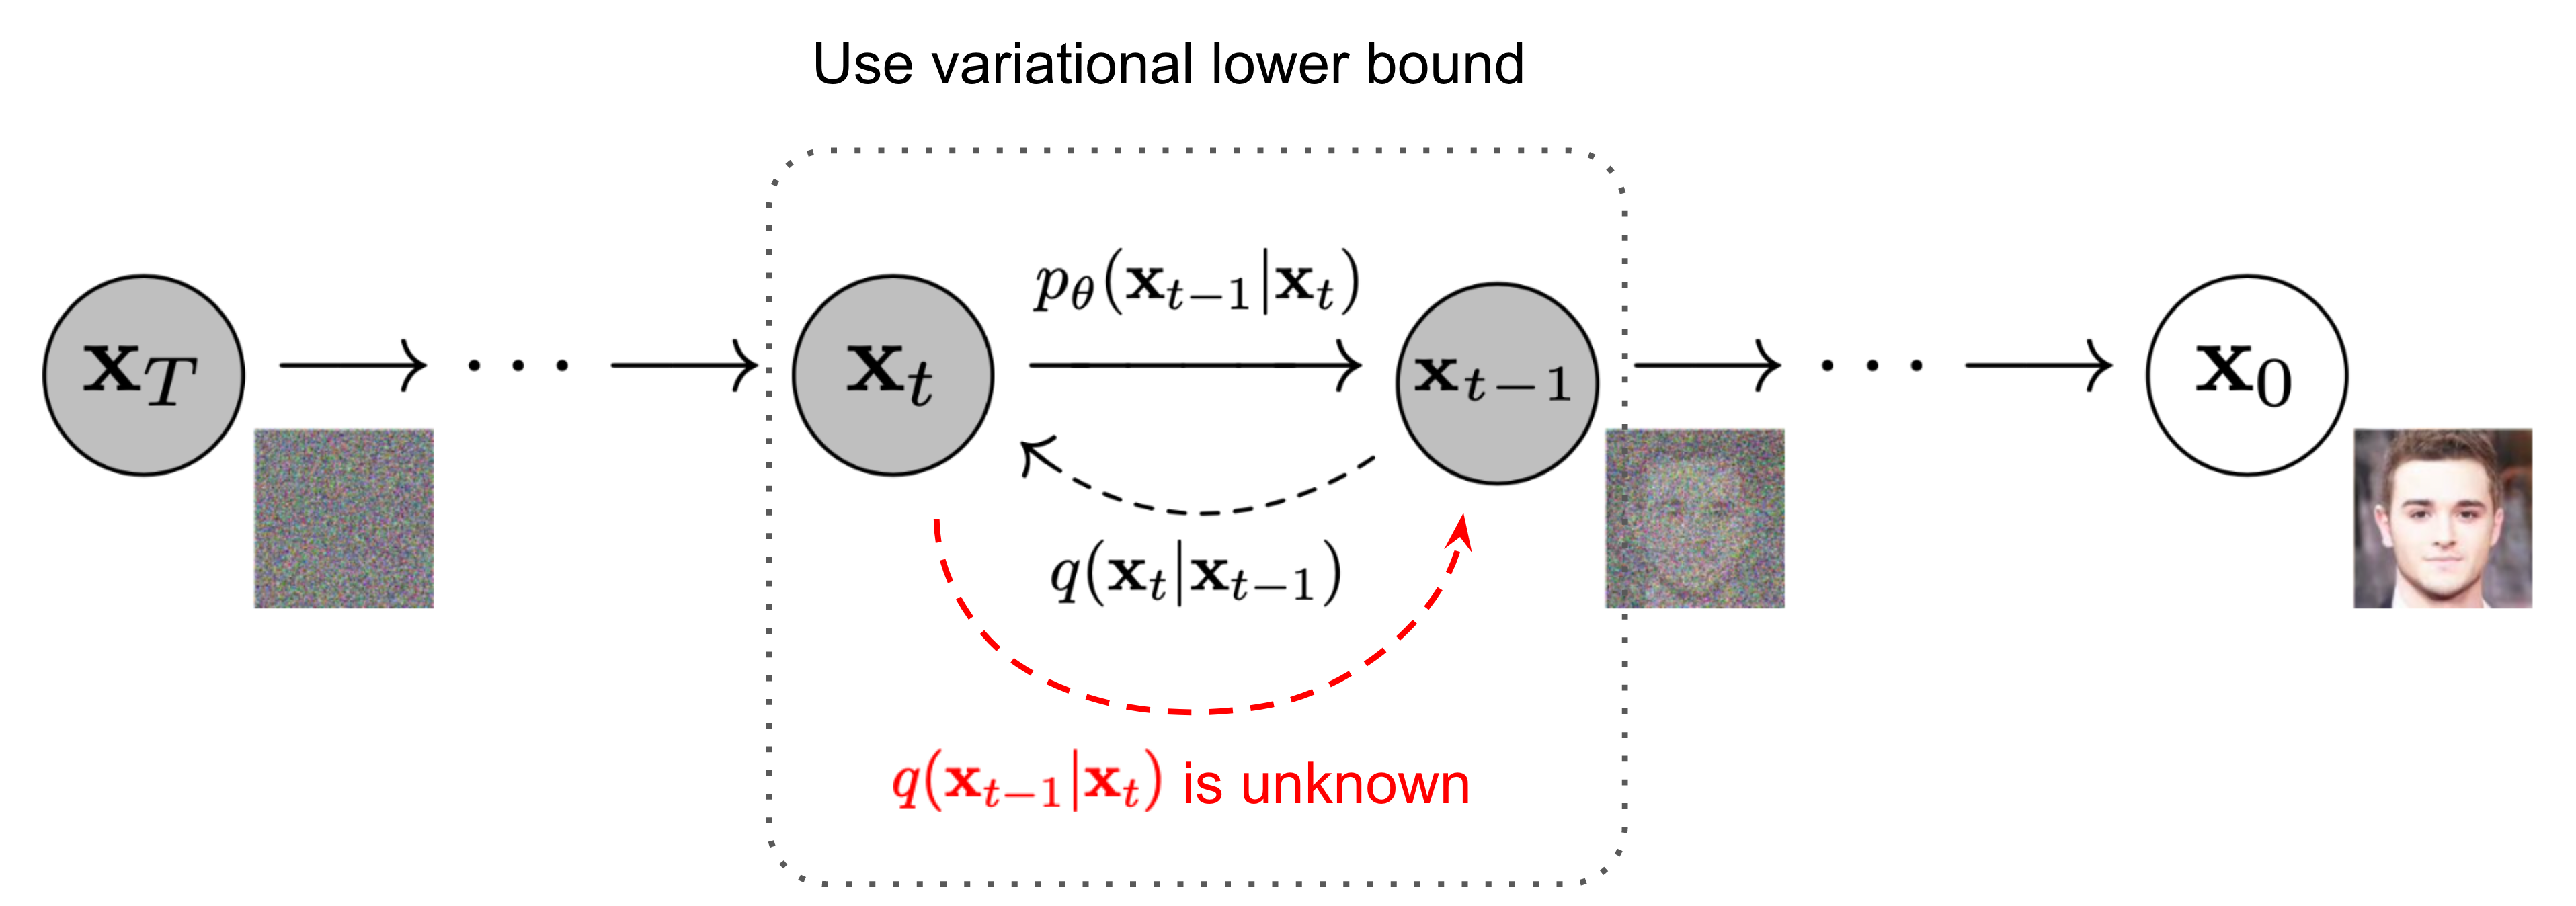 Diffusion Process.
Flow Matching2 (song song với Rectified Flow3 và Stochastic Interpolants4) đặt lại câu hỏi: _nếu biết trước vector field mục tiêu, tại sao phải simulate?__
Lấy $x_0 \sim \mathcal{N}(0,I)$ là noise, $x_1 \sim \mathcal{D}$ là data, định nghĩa:
\[x_t = (1-t)\,x_0 + t\,x_1, \qquad v_t = x_1 - x_0\]Với mỗi cặp $(x_0, x_1)$, velocity được biết trước và là hằng số. Chỉ cần regression:
\[\mathcal{L}^{\text{FM}}(\theta) = \mathbb{E}_{x_0, x_1, t}\Big[\big\|\bar{v}_\theta(x_t, t) - (x_1 - x_0)\big\|^2\Big]\]Điểm tinh tế: marginal vector field không thể tính được dưới dạng đóng, nhưng gradient của conditional loss bằng gradient của marginal loss. Regression lên các target dễ tính cho ta nghiệm của bài toán khó. Toàn bộ huấn luyện quy về regression MSE không có simulation.
Giá trị đóng góp của Flow Matching
- Objective. Least squares, target dạng đóng, không có thành phần ngẫu nhiên. Gradient variance thấp, ít hyperparameter, ổn định ở quy mô lớn.
- Transport cost. Linear interpolant tạo quỹ đạo ODE thẳng nhất — kết nối với Optimal Transport.
- Inference. ODE deterministic, không phải SDE. Dùng solver bậc cao, ánh xạ invertible, cùng seed để cho ra cùng một kết quả.
- Chi phí hệ thống. Diffusion cần 50–1000 bước; FM hạ xuống 20–30; shortcut/consistency đẩy xuống 1–4. Mỗi bước là một forward pass của transformer hàng tỉ tham số.
Ứng dụng chính
- Ảnh/video — ràng buộc chi phí. Stable Diffusion 35 và FLUX dùng rectified flow; WAN 2.x và Movie Gen dùng flow matching.
- Giọng nói — ràng buộc latency. Voicebox, Matcha-TTS, F5-TTS đưa flow/rectified flow vào TTS few-step.
- Robotics — ràng buộc thời gian thực. π₀6, SmolVLA sinh action sequence bằng flow matching; control loop 30–50Hz.
Quan trọng nhất: Flow Matching thống nhất: Diffusion, rectified flow, stochastic interpolants đều là các trường hợp riêng của cùng một khung.
2. Giới hạn cứng: vì sao một bước vẫn thất bại
Trong huấn luyện, các cặp $(x_0, x_1)$ được ghép ngẫu nhiên — tại điểm $x_t$, nhiều $x_1$ khác nhau đều hợp lệ. Nghiệm tối ưu của least squares là conditional expectation $\mathbb{E}[v_t \mid x_t]$, không phải velocity thực của một quỹ đạo. Hệ quả: tại $t=0$, mạng nhận pure noise và trả về vector trỏ đến giá trị trung bình của dataset.
Lưu ý: đây không phải là vấn đề về capacity. Kể cả ở optimum, one-step generation vẫn thất bại với mọi phân phối đa modal. Lỗi nằm ở objective, không nằm ở mô hình.
Lý giải nguồn gốc của sự nhầm lẫn trong ít bước1.
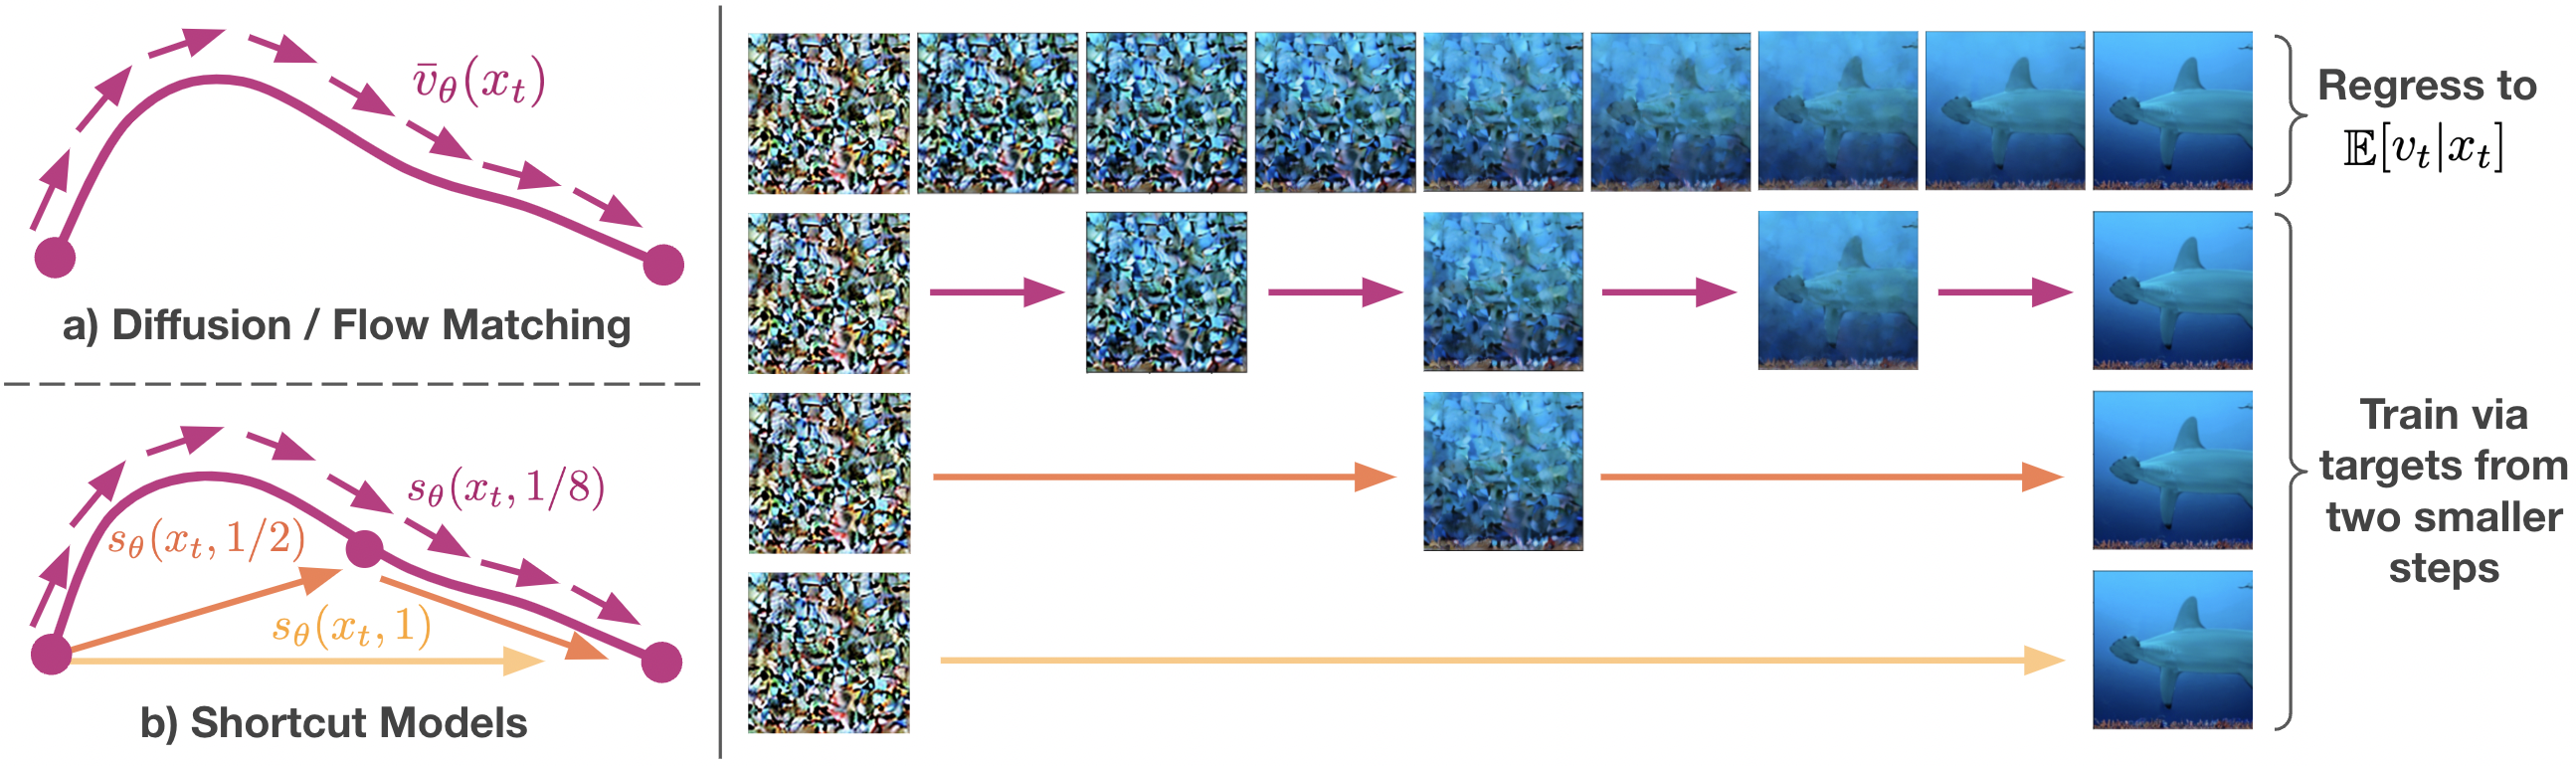 Learn a step-size conditioned model that is grounded to the data at a small step-size, and trained via self-bootstrapping at larger step-sizes.
3. Ba nhánh giải pháp
| Cần teacher? | Số lần train | Bootstrap | Cần schedule? | Giữ many-step? | |
|---|---|---|---|---|---|
| Distillation (Progressive Distillation7, Reflow) | Có | 2+ | — | Không | Không |
| Consistency Training8 | Không | 1 | $T$ | Có | Hạn chế |
| Shortcut Models | Không | 1 | $\log_2 T$ | Không | Có |
Shortcut Models khác biệt ở 2 điểm: (1) lấy $x’_{t+d}$ từ chính ODE đã học, tránh bias tích lũy của consistency models; (2) chỉ cần $\log_2 T$ bootstrap thay vì $T$. Chi phí: một bước huấn luyện shortcut tốn thêm 16% so với diffusion thông thường.
4. Cơ chế: điều kiện hóa theo $d$ và self-consistency
Gọi $\mathcal{D}_M = {1/M, \dots, 1}$ là tập step size rời rạc. Shortcut model học:
\[s_\theta : \mathcal{X} \times [0,1] \times \mathcal{D}_M \to \mathcal{X}, \qquad x'_{t+d} = x_t + s_\theta(x_t, t, d)\cdot d\]Ý tưởng: nếu mạng biết trước nó sẽ nhảy xa bao nhiêu, nó có thể tính đến độ cong phía trước và nhảy tới đúng điểm.
Target cho $d$ lớn được lấy từ self-consistency: một bước nhảy $2d$ bằng hai bước nhảy $d$ liên tiếp. Ghép với flow matching làm base case $d=0$:
\[\mathcal{L}^{\text{SC}}(\theta) = \mathbb{E}\Big[\underbrace{\|s_\theta(x_t, t, 0) - (x_1 - x_0)\|^2}_{\text{Flow-Matching}} + \underbrace{\|s_\theta(x_t, t, 2d) - s_{\text{target}}\|^2}_{\text{Self-Consistency}}\Big]\] \[s_{\text{target}} = \texttt{stopgrad}\Big(\tfrac{1}{2} s_\theta(x_t, t, d) + \tfrac{1}{2} s_\theta(x'_{t+d}, t+d, d)\Big)\]Giải thuật huấn luyện được tóm tắt như sau:
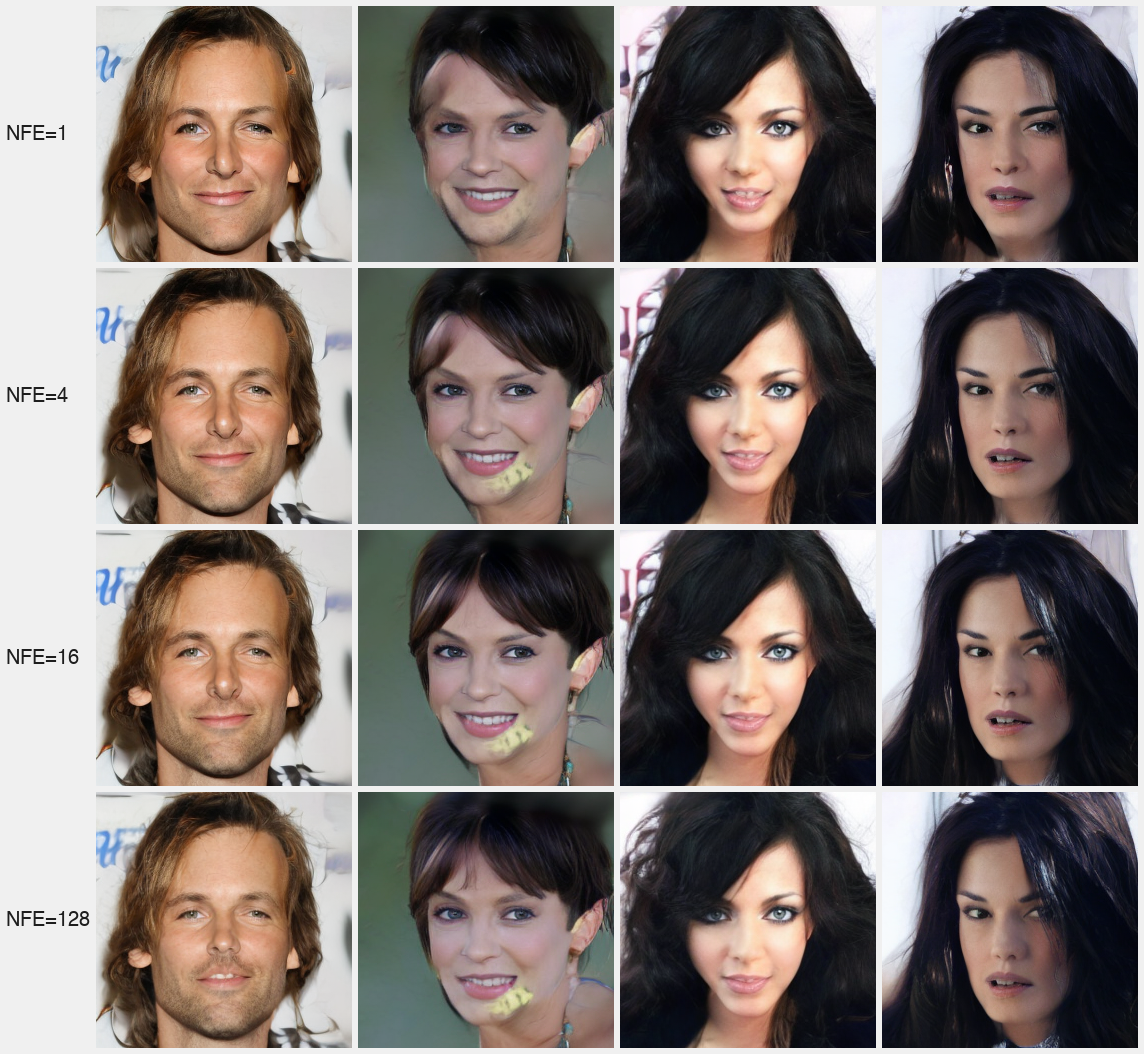 Samples from CelebA library.
Ba chi tiết quyết định: stopgrad trên cả hai lần đánh giá; EMA weights khi sinh target; weight decay $\lambda = 0.1$ — tác giả gọi là crucial. Toàn bộ phân tích lý thuyết dưới đây xoay quanh câu hỏi: ba mẹo này đang thay thế cho điều kiện toán học nào?
5. Tác giả đã bỏ ngỏ những gì
(a) Không có phân tích lý thuyết. Không có hypothesis space, không có error bound, không có điều kiện hội tụ.
(b) Kết quả trái trực giác bị bỏ lửng. Trên CelebAHQ-256, Shortcut Models đạt 128-step FID 6.9, tốt hơn Flow Matching 7.3 — dù mang thêm bootstrap bias. Tác giả gọi đây là “a blind hypothesis” về implicit regularization.
(c) Ổn định huấn luyện bằng mẹo, không bằng điều kiện. stopgrad + EMA + weight decay giữ training không phân kỳ, nhưng tại sao thì không ai chứng minh được.
(d) Khoảng cách many-step ↔ one-step vẫn còn (6.9 → 20.5), và ánh xạ noise → data bị quyết định bởi kỳ vọng trên dataset — khác với GAN hay VAE.
(e) $p(d)$ — nhân đôi nhị phân, cách đều trên thang log — không được biện luận.
Ba câu hỏi lý thuyết trung tâm:
- Hypothesis space $\mathcal{H}_{\text{SC}}$ có chứa shortcut lý tưởng $s^*$ không?
- Toán tử huấn luyện có hội tụ về $s^*$ không và dưới điều kiện nào?
- Mở rộng $\mathcal{H}_{\text{FM}} \to \mathcal{H}_{\text{SC}}$ làm thay đổi generalization error ra sao?
6. Điều tra — phân tích bằng statistical learning theory
6.1 Hypothesis space
Với $\mathcal{E}(h)$ là expected loss, $\mathcal{E}^* = \inf_h \mathcal{E}(h)$:
\[\underbrace{\mathcal{E}(h_D)}_{\text{total}} = \underbrace{\mathcal{E}^*}_{\text{optimal}} + \underbrace{\big[\mathcal{E}(h^*_{\mathcal{H}}) - \mathcal{E}^*\big]}_{\text{approximation}} + \underbrace{\big[\mathcal{E}(h_D) - \mathcal{E}(h^*_{\mathcal{H}})\big]}_{\text{estimation}}\]Mở rộng $\mathcal{H}$: approximation giảm, estimation tăng. Điều thú vị: Shortcut Models làm cả 3 hạng tử đều dịch chuyển.
Khi $d \to 0$, $s_\theta(x_t,t,0) = \bar{v}_\theta(x_t,t)$, nên $\mathcal{H}_{\text{FM}} \subset \mathcal{H}_{\text{SC}}$. Nhưng mở rộng này không phải là tự do. Nếu mỗi $d$ có bộ tham số riêng $\theta_d$, ta có $\mathcal{H}_{\text{free}} = \mathcal{H}_{\text{FM}}^{|\mathcal{D}_M|+1}$. Ràng buộc parameter sharing $\theta_d \equiv \theta$ áp đặt inductive bias. Ta được $\mathcal{H}_{\text{FM}} \subset \mathcal{H}_{\text{SC}} \subset \mathcal{H}_{\text{free}}$.
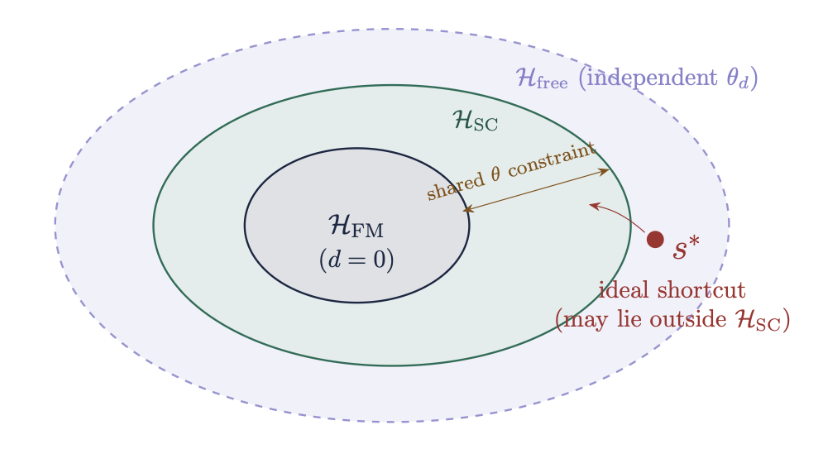 Cấu trúc hypothesis space.
6.2 Bayes floor bị nâng lên
Flow Matching có hai thành phần trong $\mathcal{E}^*$: multimodal stochasticity và discretization error $O(1/M)$. Shortcut Models thêm thành phần thứ ba:
Bootstrap bias. Tại vòng lặp $k$, target $s_{\text{target}} = f(\theta^{(k)})$ được tự động sinh ra. Dù có dữ liệu vô hạn, nếu mô hình có sai số $\varepsilon_k$, target sẽ mang sai số $O(\varepsilon_k)$. Do đó $\mathcal{E}^*_{\text{SC}} = \mathcal{E}^*_{\text{FM}} + \varepsilon_{\text{bootstrap}}$, $\varepsilon_{\text{bootstrap}} > 0$.
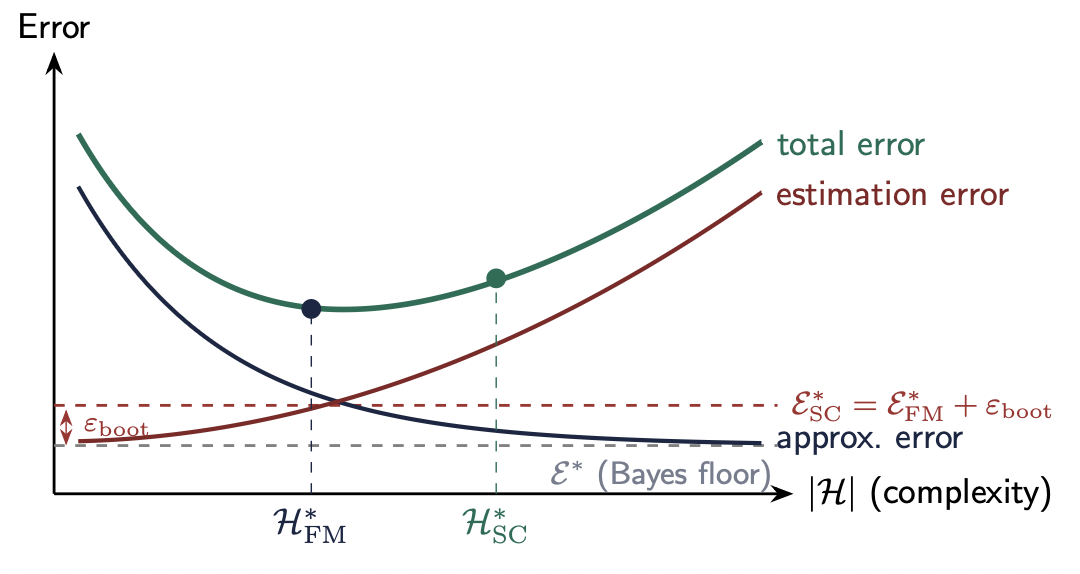 Bias - Variance analysis.
Kết quả $6.9 < 7.3$ không mâu thuẫn với bất đẳng thức trên: FID đo total error, không đo Bayes floor. $\mathcal{E}^*_{\text{SC}} > \mathcal{E}^*_{\text{FM}}$ nhưng việc ước lượng và ước tính của shortcut nhỏ hơn đủ để bù đắp. Đó là hình dạng của một regularizer: nâng sàn, hạ trần.
6.3 Approximation và estimation
Approximation — được: velocity model thuần túy không thể biểu diễn đúng các bước nhảy lớn. $\mathcal{H}_{\text{SC}}$ thêm expressiveness này.
Approximation — mất: một $\theta$ duy nhất phải đúng cho mọi $d$, tạo khoảng cách $\delta_{\text{shared}} \ge 0$ so với $\mathcal{H}_{\text{free}}$.
Estimation — moving target: $s_{\text{target}} = f(\theta^{(k-1)})$ phụ thuộc vào tham số ở thời điểm trước — tương tự như TD-learning trong RL, vốn rất bất ổn. Chứng minh rằng SGD không áp dụng hội tụ chuẩn.
Estimation — error propagation: $M=128$, $\log_2 128 = 7$ bậc lũy thừa 2. Sai số $\varepsilon_k$ ở tầng $k$ được thừa kế sang tầng $k+1$.
6.4 Kết quả chính: contraction condition $Ld < 1$
Toán tử self-consistency. $\mathcal{T} : \mathcal{H}_{\text{SC}} \to \mathcal{H}_{\text{SC}}$: \((\mathcal{T}s)(x_t, t, 2d) = \tfrac{1}{2} s(x_t, t, d) + \tfrac{1}{2} s\big(x_t + s(x_t,t,d)\cdot d,\; t+d,\; d\big)\). Huấn luyện là tìm fixed point $\mathcal{T}s^* = s^*$.
Định lý. Giả sử $s^*_\theta$ thỏa mãn $|s^*_\theta(x,t,d) - s^*_\theta(y,t,d)| \le L|x-y|$. Khi đó, $\mathcal{T}$ là một contraction mapping với hệ số $\kappa = \frac{1+Ld}{2}$. Theo Banach fixed-point theorem9, $\mathcal{T}$ có fixed point duy nhất và hội tụ khi $\kappa < 1$, tức $\boxed{Ld < 1}$.
Chứng minh. Đặt $x’_{t+d} = x_t + s(x_t,t,d)d$ và tương tự cho $\tilde{s}$:
\[\|x'_{t+d} - \tilde{x}'_{t+d}\| = d\|s - \tilde{s}\|_\infty\]Áp dụng triangle inequality cho hai nửa của $\mathcal{T}$:
\[\|(\mathcal{T}s) - (\mathcal{T}\tilde{s})\| \le \tfrac{1}{2}\|s - \tilde{s}\|_\infty + \tfrac{1}{2}\big(\|s - \tilde{s}\|_\infty + L d \|s - \tilde{s}\|_\infty\big) = \tfrac{1+Ld}{2}\|s-\tilde{s}\|_\infty\]Lấy supremum. $\square$
Ba hệ quả:
- Điều kiện khắt khe nhất ở one-step ($d=1$): $L < 1$ — mạng phải là contraction theo input.
- Weight decay là proxy, không phải bằng chứng. Paper không đo $L$; dùng weight decay và EMA để gián tiếp chặn $L$.
- Norm mismatch: chứng minh dùng $\ell_\infty$, huấn luyện dùng $\ell_2$.
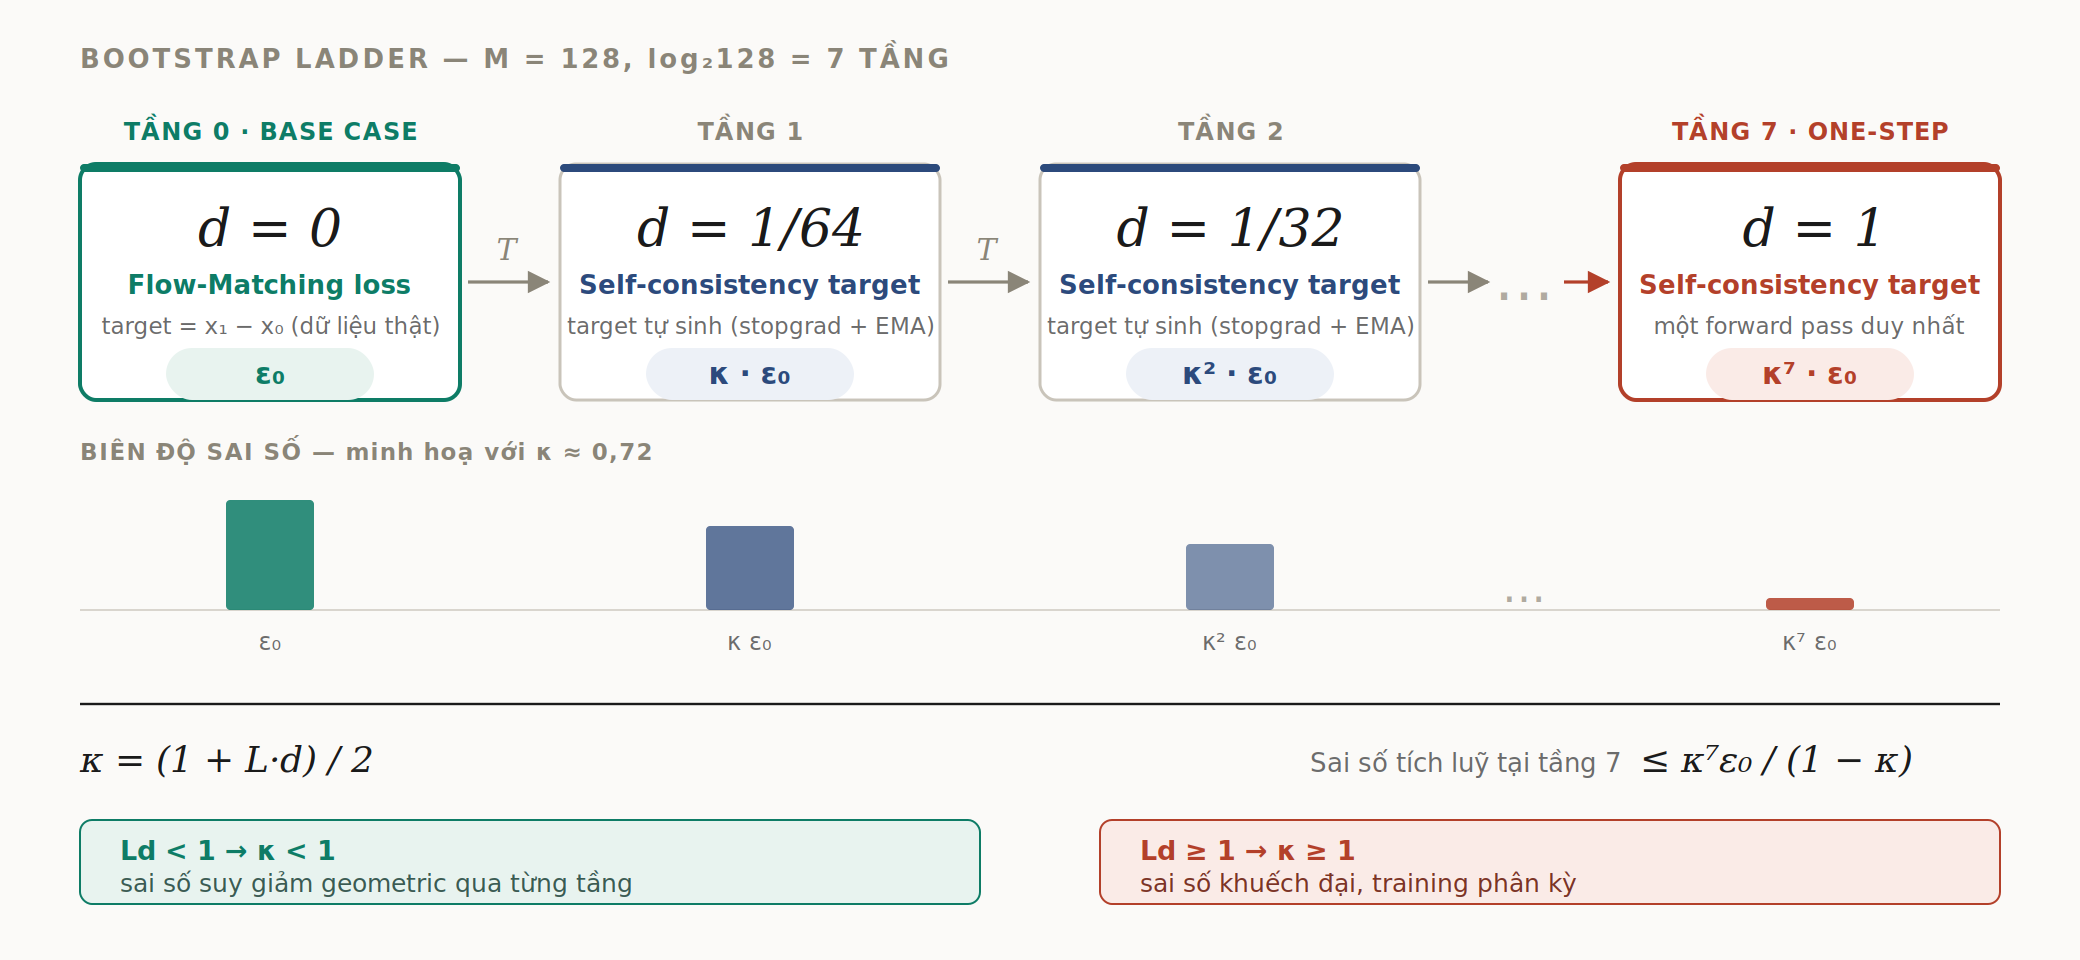 Error propagation qua 7 tầng.
6.5 Generalization bound
| Hướng tiếp cận | Đánh giá |
|---|---|
| Complexity-based (VC dim, Rademacher) | ❌ Với DiT-B hàng trăm triệu tham số, bound > 1 |
| Algorithmic stability10 | ✅ Khả thi nhất |
| PAC-Bayes | ⚠️ Vướng phụ thuộc vòng |
| Sharpness-based | ⚠️ Tính được sau train |
Với stability: $\beta = \frac{\eta\,\delta}{1 - \kappa} = \frac{\eta\,\delta}{(1 - Ld)/2}$.
7. Kết
Flow Matching kéo NFE từ hàng trăm xuống hàng chục bằng cách đơn giản hóa. Shortcut Models kéo từ hàng chục về một — vẫn là một mạng, một lần huấn luyện.
Nhưng đây là phương pháp bootstrap, và nó không sụp đổ mà không ai biết chắc tại sao. Phân tích ở trên đưa ra một câu trả lời: nếu $Ld < 1$, self-consistency là một contraction mapping, fixed point tồn tại và duy nhất, và sai số giảm theo cấp số nhân sau 7 tầng. Nếu không, mọi thứ đều đứng vững nhờ weight decay và sự may mắn.
Ba mẹo engineering — stopgrad, EMA, weight decay — hóa ra là 3 cách gián tiếp để giữ $L$ ở mức đủ thấp. Thứ tác giả để ngỏ không phải phương pháp, mà là lý do phương pháp hoạt động. Khoảng cách giữa hai thứ đó rộng đúng bằng một phép đo spectral norm mà chưa ai thực hiện.
Tham khảo
-
K. Frans, D. Hafner, S. Levine, P. Abbeel. One Step Diffusion via Shortcut Models. ICLR, 2025. arXiv:2410.12557 ↩ ↩2
-
Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel, M. Le. Flow Matching for Generative Modeling. ICLR, 2023. arXiv:2210.02747 ↩
-
X. Liu, C. Gong, Q. Liu. Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow. ICLR, 2023. arXiv:2209.03003 ↩
-
M. S. Albergo, E. Vanden-Eijnden. Building Normalizing Flows with Stochastic Interpolants. ICLR, 2023. arXiv:2209.15571 ↩
-
P. Esser và cộng sự. Scaling Rectified Flow Transformers for High-Resolution Image Synthesis. ICML, 2024. arXiv:2403.03206 ↩
-
K. Black và cộng sự. π₀: A Vision-Language-Action Flow Model for General Robot Control. 2024. arXiv:2410.24164 ↩
-
T. Salimans, J. Ho. Progressive Distillation for Fast Sampling of Diffusion Models. ICLR, 2022. arXiv:2202.00512 ↩
-
Y. Song, P. Dhariwal, M. Chen, I. Sutskever. Consistency Models. ICML, 2023. arXiv:2303.01469 ↩
-
S. Banach. Sur les opérations dans les ensembles abstraits et leur application aux équations intégrales. Fundamenta Mathematicae, 3(1):133–181, 1922. ↩
-
O. Bousquet, A. Elisseeff. Stability and Generalization. JMLR, 2:499–526, 2002. ↩
